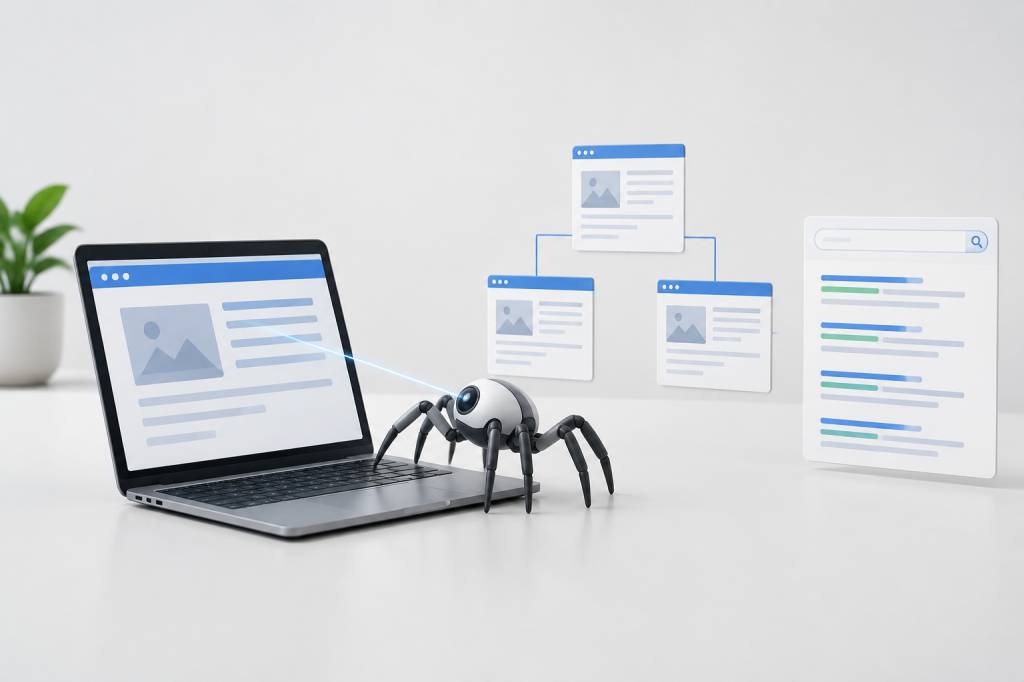
Votre site peut être magnifique, rapide et rempli de contenus brillants. Mais si les moteurs de recherche ne parviennent pas à le parcourir, il restera aussi visible qu’un panneau publicitaire au fond d’une grotte. C’est précisément là qu’interviennent les crawlers web, aussi appelés robots d’exploration, spiders ou bots.
Ces programmes parcourent le Web, découvrent les pages, analysent leur contenu et transmettent leurs informations aux moteurs de recherche. Sans eux, Google, Bing et les autres moteurs auraient bien du mal à savoir quelles pages afficher dans leurs résultats.
Mais que font-ils exactement ? Comment explorent-ils un site ? Quel est leur impact sur le référencement naturel ? Et surtout, comment éviter de leur compliquer inutilement la tâche ? Plongeons dans les coulisses de l’exploration web, sans combinaison d’astronaute, mais avec quelques notions techniques bien utiles.
Qu’est-ce qu’un crawler web ?
Un crawler web est un logiciel automatisé capable de visiter des pages internet, de suivre des liens et d’analyser les ressources rencontrées. Les moteurs de recherche utilisent leurs propres robots. Le plus connu est Googlebot, mais il existe également Bingbot, YandexBot, Baiduspider ou encore DuckDuckBot.
Le principe est relativement simple : le robot part d’une liste d’URL connues, consulte les pages correspondantes, puis suit les liens présents sur ces pages pour en découvrir de nouvelles. Petit à petit, il cartographie une partie du Web. Une sorte de GPS numérique, sauf qu’il ne vous indiquera jamais le meilleur restaurant thaïlandais à proximité.
Les crawlers ne se limitent pas aux moteurs de recherche. D’autres robots explorent le Web pour :
- Analyser la performance et la santé technique d’un site ;
- Vérifier la disponibilité d’une page ;
- Collecter des données publiques ;
- Scanner des sites à la recherche de vulnérabilités ;
- Contrôler les liens et les contenus ;
- Alimenter des outils SEO comme Screaming Frog, Semrush ou Ahrefs.
Tous les robots ne sont donc pas utiles, et certains peuvent même consommer inutilement les ressources d’un serveur. Il est important de savoir qui vient visiter votre site et pourquoi.
Comment fonctionne l’exploration d’un site ?
Lorsqu’un crawler arrive sur un domaine, il commence généralement par consulter le fichier robots.txt. Celui-ci se trouve à la racine du site, à l’adresse suivante :
https://www.exemple.com/robots.txt
Ce fichier contient des directives indiquant les zones que certains robots peuvent ou ne peuvent pas explorer. Par exemple, vous pouvez demander à Googlebot de ne pas accéder à un espace d’administration ou à des pages internes sans intérêt pour le référencement.
Une fois cette étape passée, le robot tente de découvrir les URL accessibles. Il peut les trouver grâce :
- Aux liens internes ;
- Aux liens externes provenant d’autres sites ;
- Au fichier sitemap.xml ;
- À son historique d’exploration ;
- Aux redirections et aux variantes d’URL déjà connues.
Le crawler télécharge ensuite le contenu de la page. Il examine le HTML, les balises title et meta description, les titres, les liens, les images, les données structurées et différents signaux techniques. Les moteurs modernes peuvent également exécuter du JavaScript, mais cette opération demande davantage de ressources. Une page qui dépend entièrement de scripts complexes n’est donc pas toujours aussi facile à explorer qu’une page HTML bien structurée.
Après l’exploration vient une autre étape : l’indexation. Le moteur décide alors si la page mérite d’être enregistrée dans sa base de données, pour quelles requêtes elle pourrait être pertinente et quelle version doit être considérée comme principale.
Exploration et indexation sont deux notions différentes. Une page peut être explorée sans être indexée. Elle peut aussi être découverte, mais rester inaccessible au robot à cause d’un problème technique. Cette nuance explique pourquoi une URL présente dans Google Search Console n’apparaît pas forcément dans les résultats.
Exploration, indexation et classement : trois étapes à ne pas confondre
Pour comprendre l’impact des crawlers sur le SEO, il faut distinguer trois phases :
- L’exploration : le robot visite et lit la page ;
- L’indexation : le moteur enregistre la page dans sa base ;
- Le classement : l’algorithme positionne la page dans les résultats selon la requête de l’internaute.
Une page non explorée ne peut généralement pas être indexée. Une page indexée n’est pas forcément bien positionnée. Et une page correctement positionnée peut perdre des places si son contenu devient obsolète, si la concurrence progresse ou si l’expérience utilisateur se dégrade.
Le crawler est donc le premier maillon de la chaîne, pas le responsable de tout le référencement. Lui faire parvenir une page est indispensable, mais cela ne garantit pas un ticket direct pour la première position.
Pourquoi les crawlers sont essentiels au SEO ?
Les robots d’exploration permettent aux moteurs de découvrir vos contenus et de les prendre en compte. Sans exploration régulière, une nouvelle page peut rester invisible pendant longtemps, même si elle répond parfaitement aux recherches de votre audience.
Ils jouent également un rôle dans la mise à jour des informations. Si vous modifiez un titre, améliorez un contenu ou corrigez une erreur, le moteur doit repasser sur la page pour constater les changements. Plus votre site est régulièrement exploré, plus les mises à jour peuvent être détectées rapidement.
Les crawlers analysent aussi la structure globale du site. Ils observent notamment :
- La profondeur des pages ;
- La qualité du maillage interne ;
- La présence de liens cassés ;
- Les redirections ;
- Les doublons de contenu ;
- Les erreurs serveur ;
- La compatibilité mobile et la vitesse de chargement.
En clair, un site facile à parcourir est généralement plus simple à comprendre pour les moteurs. Et ce qui est simple à comprendre a davantage de chances d’être correctement valorisé.
Le budget de crawl, cette ressource à ne pas gaspiller
Les moteurs de recherche ne disposent pas de ressources infinies pour explorer chaque site. Ils attribuent donc un certain volume de visites à chaque domaine : c’est ce que l’on appelle le crawl budget, ou budget d’exploration.
Pour un petit site de quelques dizaines de pages, ce sujet reste rarement critique. En revanche, il devient stratégique pour les sites e-commerce, les médias, les plateformes comportant des milliers d’URL ou les sites générant automatiquement de nombreuses variantes.
Imaginez un magasin dans lequel le vendeur passe son temps à ouvrir des portes menant vers des pièces vides. Il n’a plus beaucoup de temps pour visiter les rayons importants. C’est exactement ce qui peut se produire lorsqu’un crawler gaspille ses visites sur :
- Des pages filtrées avec de nombreuses variantes d’URL ;
- Des pages de recherche interne ;
- Des contenus très pauvres ;
- Des paramètres inutiles ;
- Des redirections en chaîne ;
- Des URL dupliquées ;
- Des pages d’erreur.
Pour optimiser votre budget de crawl, commencez par nettoyer la structure technique du site. Supprimez les URL inutiles, limitez les paramètres générant des doublons, corrigez les liens cassés et facilitez l’accès aux pages stratégiques grâce au maillage interne.
Le fichier robots.txt : puissant, mais parfois piégeux
Le fichier robots.txt sert à donner des consignes aux robots. Voici un exemple simple :
User-agent: *
Disallow: /admin/
Disallow: /panier/
Sitemap: https://www.exemple.com/sitemap.xml
Cette configuration indique à tous les robots de ne pas explorer les répertoires admin et panier, tout en leur fournissant l’adresse du sitemap.
Attention toutefois : Disallow ne signifie pas forcément “ne pas indexer”. Une URL bloquée dans robots.txt peut parfois être connue par Google grâce à des liens externes et apparaître malgré tout dans les résultats, sans contenu détaillé.
Si vous souhaitez empêcher l’indexation d’une page, la directive noindex est généralement plus adaptée, à condition que le robot puisse accéder à la page et lire cette directive. Bloquer une URL dans robots.txt tout en espérant que Google découvre son noindex revient à fermer la porte au facteur avant de lui remettre la lettre.
Le sitemap XML facilite le travail des robots
Le sitemap.xml est un fichier qui répertorie les URL importantes d’un site. Il aide les moteurs à découvrir les pages qui pourraient être difficiles à atteindre via les liens internes.
Un sitemap efficace doit contenir :
- Les URL canoniques et accessibles ;
- Les pages utiles pour les internautes ;
- Des adresses renvoyant un code HTTP 200 ;
- Des contenus réellement indexables ;
- Des URL mises à jour lorsque le contenu évolue.
Évitez d’y ajouter des pages supprimées, redirigées, bloquées ou marquées en noindex. Un sitemap rempli d’URL inutiles envoie des signaux contradictoires aux moteurs.
Vous pouvez généralement déclarer le sitemap dans Google Search Console et dans le fichier robots.txt. Cela ne force pas l’indexation, mais cela améliore la découverte des contenus importants.
Les erreurs qui ralentissent l’exploration
Certains problèmes techniques compliquent sérieusement le travail des crawlers. Les erreurs 404, par exemple, indiquent qu’une page n’existe pas. Quelques liens cassés sont inévitables, mais leur accumulation donne une image peu soignée du site et gaspille des visites.
Les erreurs 500 sont encore plus préoccupantes. Elles signalent un problème côté serveur et empêchent souvent le robot de consulter la page. Si elles se répètent, le moteur peut réduire temporairement la fréquence d’exploration du domaine.
Les redirections sont utiles lorsqu’une URL change, mais une chaîne de redirections ralentit le parcours. Une page qui redirige vers une autre, qui redirige elle-même vers une troisième, n’est pas un parcours idéal. Dans la mesure du possible, créez une redirection directe vers l’URL finale.
Les temps de chargement élevés posent également problème. Un crawler doit attendre davantage avant de passer à la page suivante. Pour améliorer la situation, travaillez sur la compression des images, la mise en cache, le poids des fichiers CSS et JavaScript ainsi que la qualité de l’hébergement.
Comment savoir si Google explore correctement votre site ?
Plusieurs outils permettent de surveiller le comportement des crawlers. Le premier est Google Search Console. Le rapport sur les pages indexées permet d’identifier les URL exclues, les erreurs et les problèmes d’exploration.
Le rapport de statistiques sur l’exploration fournit également des informations sur :
- Le nombre de requêtes effectuées par Googlebot ;
- Le volume de données téléchargées ;
- Le temps de réponse moyen du serveur ;
- Les principaux problèmes rencontrés.
Pour une analyse plus complète, un crawler SEO comme Screaming Frog, Sitebulb ou Oncrawl peut simuler l’exploration d’un moteur et révéler les faiblesses de votre architecture.
Les fichiers de logs serveur sont encore plus précis. Ils permettent de savoir quelles URL ont réellement été visitées par Googlebot, Bingbot ou d’autres robots. C’est une approche particulièrement intéressante pour les gros sites, car elle montre la différence entre ce que vous pensez accessible et ce que les moteurs explorent réellement.
Les bonnes pratiques pour rendre un site crawl-friendly
Un site facile à explorer repose sur une architecture claire et une base technique propre. Voici les actions prioritaires à mettre en place :
- Créer une structure de navigation logique ;
- Relier les pages importantes avec des liens internes pertinents ;
- Générer un sitemap XML propre et régulièrement mis à jour ;
- Vérifier la configuration du fichier robots.txt ;
- Corriger les erreurs 404 et 500 ;
- Réduire les chaînes de redirections ;
- Éviter les contenus dupliqués et les URL inutiles ;
- Améliorer la vitesse de chargement ;
- Utiliser des balises canoniques cohérentes ;
- Limiter la dépendance à des scripts JavaScript complexes ;
- Contrôler régulièrement les rapports de Google Search Console.
Le maillage interne mérite une attention particulière. Un lien n’est pas seulement un moyen de faire passer l’internaute d’une page à l’autre : c’est aussi un signal qui aide les robots à comprendre la hiérarchie et la popularité relative de vos contenus.
Les crawlers et le netlinking
Le netlinking joue également un rôle dans la découverte des pages. Lorsqu’un site externe fait un lien vers l’une de vos URL, les robots peuvent suivre ce lien et découvrir votre contenu. Plus le site référent est régulièrement exploré, plus cette découverte peut être rapide.
Mais un backlink ne remplace pas une bonne architecture. Si la page ciblée est bloquée, lente, redirigée ou isolée du reste du site, le lien perd une partie de son intérêt. Avant de chercher toujours plus de backlinks, vérifiez donc que les robots peuvent accéder facilement aux pages que vous souhaitez pousser.
Un bon lien externe attire de l’autorité. Un bon maillage interne la distribue. Et une structure technique propre évite de la faire disparaître dans un trou noir numérique.
Les crawlers ne sont pas vos ennemis
Les crawlers peuvent sembler mystérieux, voire envahissants, mais ils sont indispensables à la visibilité organique. Leur mission consiste à parcourir, comprendre et actualiser les contenus accessibles sur votre site.
Votre rôle consiste à leur proposer un chemin clair : des pages utiles, des liens cohérents, un serveur réactif et des indications techniques sans contradiction. En retour, les moteurs disposent de meilleures informations pour explorer et indexer votre site.
La prochaine fois que vous publierez une page, ne vous contentez pas de vérifier son design. Demandez-vous aussi : le robot peut-il la trouver ? Peut-il la charger ? Comprend-il son sujet ? Est-elle reliée aux autres contenus importants ?
En SEO, la visibilité commence souvent bien avant la page de résultats. Elle commence au moment où un crawler arrive à votre porte et décide, ou non, d’entrer.