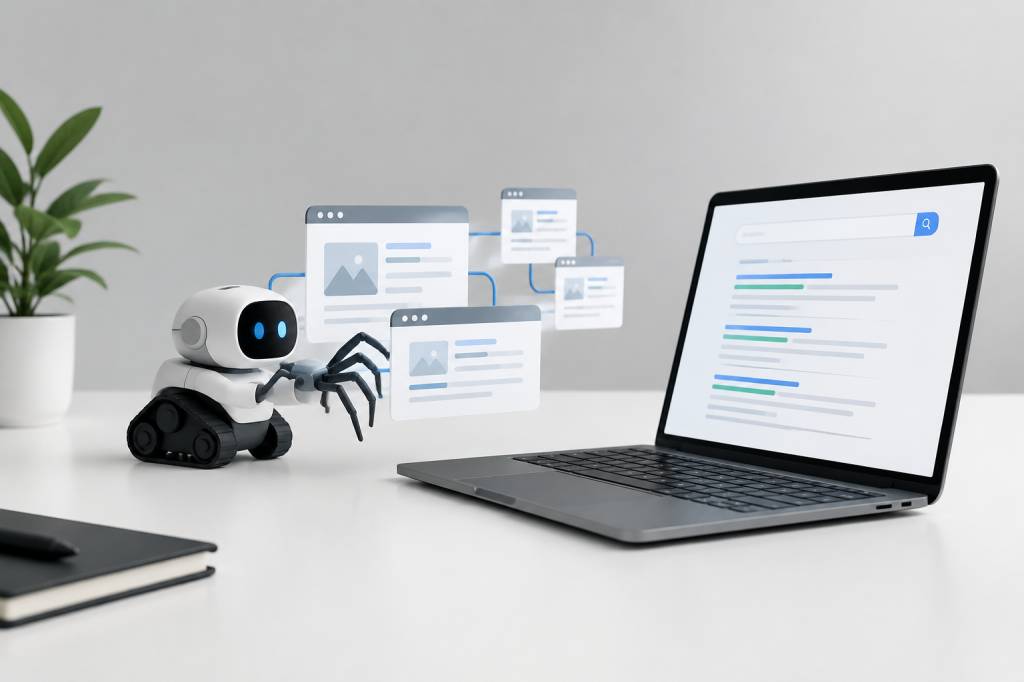
Sur le Web, personne ne parcourt Internet avec une carte routière complète. Pourtant, les moteurs de recherche parviennent à découvrir des milliards de pages, à les analyser et à les classer en quelques fractions de seconde. Leur secret ? Des robots logiciels appelés crawlers web, ou robots d’exploration.
Ces petits assistants numériques jouent un rôle central dans le référencement naturel. Sans eux, votre superbe article, votre fiche produit parfaitement optimisée ou votre page d’accueil fraîchement retravaillée pourraient rester totalement invisibles dans Google. Un peu comme ouvrir une boutique flambant neuve au fond d’une ruelle sans panneau ni adresse GPS.
Mais comment fonctionne réellement un crawler ? Que vient-il observer sur un site ? Et surtout, comment optimiser son SEO pour faciliter son travail ? Plongeons dans les coulisses de l’exploration du Web.
Qu’est-ce qu’un crawler web ?
Un crawler web est un programme automatisé conçu pour parcourir les pages Internet. Il suit les liens présents sur les sites, collecte des informations et les transmet aux moteurs de recherche afin qu’elles soient analysées puis éventuellement ajoutées à leur index.
Google utilise notamment plusieurs robots, dont le célèbre Googlebot. Bing possède son propre crawler, Bingbot, tandis que d’autres moteurs disposent également de leurs agents d’exploration.
Le terme « crawler » vient de l’anglais to crawl, qui signifie ramper. L’image est assez parlante : le robot avance de lien en lien, page après page, pour découvrir de nouveaux contenus. Heureusement, il ne fait pas de bruit et ne laisse pas de traces de pas dans votre serveur… seulement des lignes dans vos fichiers de logs.
Il existe également des crawlers utilisés à d’autres fins :
- Les robots des moteurs de recherche, destinés à découvrir et analyser les pages.
- Les crawlers SEO, utilisés par des outils comme Screaming Frog, Semrush ou Ahrefs.
- Les robots de surveillance, qui vérifient la disponibilité ou les performances d’un site.
- Les crawlers malveillants, qui peuvent tenter de récupérer des données ou de surcharger un serveur.
Dans le cadre du référencement, on s’intéresse principalement aux robots des moteurs et aux outils d’audit SEO.
Comment fonctionne l’exploration d’un site ?
Le parcours d’un crawler commence généralement avec une liste d’URL appelée file d’attente d’exploration. Cette liste contient des adresses connues du moteur, issues de précédentes explorations, de liens externes ou encore d’un sitemap XML transmis via Google Search Console.
Le robot visite ensuite une URL, télécharge la page et analyse son contenu. Il repère les liens internes et externes, puis ajoute les nouvelles adresses découvertes à sa liste de pages à explorer. Le processus se répète en permanence.
Imaginons un site e-commerce qui vend des chaussures. Le crawler arrive sur la page d’accueil, découvre les catégories « chaussures de running », « baskets lifestyle » et « chaussures de randonnée », puis suit ces liens. Sur chaque catégorie, il rencontre de nouvelles fiches produits. Si les liens sont correctement construits, le robot peut parcourir l’ensemble du catalogue sans trop d’effort.
En revanche, si certaines pages ne sont accessibles qu’après plusieurs clics, si des liens sont cassés ou si la navigation repose entièrement sur du JavaScript mal interprété, le crawler risque de perdre le fil. Et un robot perdu dans un site, c’est rarement une bonne nouvelle pour la visibilité.
Exploration, indexation et classement : trois étapes différentes
Une confusion revient souvent en SEO : être crawlé ne signifie pas automatiquement être positionné dans Google. Le fonctionnement d’un moteur de recherche repose sur plusieurs étapes distinctes.
- L’exploration : le robot découvre et parcourt une URL.
- L’indexation : le moteur analyse la page et décide s’il doit l’enregistrer dans sa base de données.
- Le classement : l’algorithme détermine la position de la page dans les résultats selon la requête de l’internaute.
Une page peut donc être explorée sans être indexée. C’est notamment le cas lorsqu’elle est considérée comme trop pauvre, dupliquée, peu utile ou techniquement problématique.
À l’inverse, une page peut être indexée sans obtenir une bonne position. Elle existe dans la base du moteur, mais ses contenus, son autorité ou son expérience utilisateur ne suffisent pas à la faire remonter. Le crawler ouvre la porte, mais il ne distribue pas les médailles.
Que regarde un crawler sur une page web ?
Lorsqu’il analyse une page, un robot examine de nombreux éléments. Il ne lit pas exactement comme un humain, même si les moteurs sont devenus très performants pour comprendre le contexte et l’intention d’un contenu.
Le crawler s’intéresse notamment aux éléments suivants :
- La balise title, qui indique le sujet principal de la page.
- La méta-description, utile pour présenter le contenu dans les résultats.
- Les balises de titres comme H1, H2 et H3.
- Le texte visible et sa pertinence par rapport au sujet traité.
- Les liens internes et externes.
- Les images, leur poids et leur attribut alt.
- Les données structurées, lorsqu’elles sont présentes.
- La version mobile et les performances techniques.
- Les directives contenues dans le fichier robots.txt et les balises meta robots.
Il analyse également la structure générale du site. Une architecture claire aide les robots à comprendre les relations entre les contenus. Une page pilier consacrée au SEO peut ainsi renvoyer vers des articles plus précis sur le crawl budget, les erreurs 404 ou les backlinks.
Le rôle du fichier robots.txt
Le fichier robots.txt se trouve généralement à la racine d’un site, par exemple à l’adresse monsite.be/robots.txt. Il permet d’indiquer aux robots les zones qu’ils peuvent explorer ou qu’il vaut mieux éviter.
Voici un exemple simple :
User-agent: *
Disallow: /admin/
Disallow: /panier/
Dans ce cas, tous les robots sont invités à ne pas explorer les répertoires « admin » et « panier ».
Attention toutefois : le fichier robots.txt n’est pas un système de sécurité. Il donne une consigne aux robots respectueux, mais n’empêche pas un robot malveillant d’accéder à une URL. Pour protéger une zone privée, il faut utiliser une authentification ou une restriction serveur.
Autre piège classique : bloquer par erreur une ressource essentielle, comme des fichiers CSS ou JavaScript. Le robot pourrait alors voir une page différente de celle affichée aux visiteurs. Avant toute modification, mieux vaut vérifier les règles avec les outils proposés par Google Search Console ou un crawler SEO.
Le sitemap XML facilite-t-il le travail des robots ?
Oui, à condition de l’utiliser correctement. Un sitemap XML rassemble les URL importantes d’un site et aide les moteurs à les découvrir plus rapidement. Il est particulièrement utile pour les sites volumineux, les boutiques en ligne ou les domaines récents qui disposent encore de peu de liens externes.
Un sitemap ne garantit pas l’indexation de toutes les URL qu’il contient. Il fonctionne plutôt comme une liste de recommandations. Si vous y placez des pages en erreur, des URL redirigées ou des contenus que vous ne souhaitez pas indexer, vous envoyez des signaux contradictoires.
Un bon sitemap doit donc contenir principalement :
- Des URL accessibles et renvoyant un code HTTP 200.
- Des pages utiles pour les internautes.
- Des versions canoniques, sans doublons inutiles.
- Des contenus réellement destinés à apparaître dans les résultats.
Après sa création, le sitemap peut être envoyé dans Google Search Console et référencé dans le fichier robots.txt.
Le crawl budget : une ressource à ne pas gaspiller
Le crawl budget, ou budget d’exploration, désigne la quantité de ressources qu’un moteur consacre à l’exploration d’un site sur une période donnée. Ce budget dépend notamment de la taille du site, de sa popularité, de la fréquence de publication et de la capacité du serveur à répondre rapidement.
Pour un petit site vitrine de dix pages, cette notion est rarement préoccupante. Google parviendra généralement à tout explorer sans difficulté. En revanche, un catalogue de 100 000 produits peut rapidement rencontrer des problèmes : filtres générant des milliers d’URL, paramètres de tracking, pages presque identiques ou erreurs serveur à répétition.
Optimiser son crawl budget revient à concentrer l’attention des robots sur les pages qui méritent réellement d’être explorées. Il faut notamment :
- Limiter les URL générées automatiquement sans intérêt SEO.
- Éviter les chaînes de redirections trop longues.
- Corriger les erreurs 404 et les erreurs serveur.
- Renforcer le maillage interne vers les pages stratégiques.
- Réduire les contenus dupliqués ou très faibles.
- Améliorer la vitesse et la stabilité du serveur.
Le principe est simple : ne demandez pas à Google de visiter la cave, le grenier et les tiroirs du bureau si votre contenu le plus important se trouve au rez-de-chaussée.
Pourquoi les liens internes sont essentiels pour le crawl ?
Les liens internes servent à la navigation des internautes, mais aussi à la circulation des robots. Ils indiquent quelles pages sont accessibles et comment les contenus sont organisés.
Une page importante ne devrait pas être isolée. Si elle n’est reliée par aucun lien interne, elle devient une page orpheline. Même si elle figure dans un sitemap, elle reçoit peu de signaux contextuels et risque d’être moins bien explorée et moins bien comprise.
Un maillage interne efficace doit relier les pages de manière logique. Un article sur les backlinks peut pointer vers un guide consacré aux ancres de liens, à l’autorité de domaine ou à la détection des liens toxiques. Cette organisation aide le lecteur à approfondir le sujet tout en transmettant de la popularité SEO aux pages liées.
Privilégiez des ancres descriptives. « Découvrez notre guide sur le netlinking » est plus informatif que « cliquez ici ». Le robot apprécie la précision. Le lecteur aussi, généralement.
Les erreurs qui empêchent un crawler de travailler correctement
Certains problèmes techniques reviennent régulièrement lors des audits SEO. Ils peuvent ralentir l’exploration ou empêcher l’accès à des pages importantes.
- Les erreurs 404 : elles indiquent qu’une page demandée n’existe pas.
- Les erreurs 500 : elles révèlent un problème côté serveur.
- Les redirections en chaîne : elles allongent inutilement le parcours du robot.
- Les liens cassés : ils interrompent la circulation entre les pages.
- Les blocages robots.txt : une directive mal configurée peut rendre une section inaccessible.
- Les balises noindex : elles demandent aux moteurs de ne pas indexer la page.
- Les contenus uniquement accessibles via des interactions complexes : certains éléments peuvent être difficiles à interpréter.
Une autre erreur fréquente consiste à créer de nombreuses pages très similaires pour cibler des variantes de mots-clés. Cette stratégie, autrefois populaire, peut aujourd’hui donner une impression de contenu artificiel et gaspiller les ressources d’exploration.
Comment vérifier le passage des crawlers sur son site ?
Plusieurs outils permettent de contrôler la manière dont les robots explorent un site. Google Search Console fournit notamment des rapports sur l’indexation, les pages exclues, les erreurs rencontrées et les statistiques d’exploration.
Les fichiers de logs serveur offrent une vision encore plus précise. Ils indiquent quelles URL ont été demandées, par quel robot et à quel moment. On peut ainsi découvrir que Googlebot passe beaucoup de temps sur des paramètres inutiles au lieu de visiter les pages commerciales prioritaires.
Les crawlers SEO comme Screaming Frog, Sitebulb, Semrush ou Ahrefs permettent également de simuler l’exploration d’un site. Ils détectent les liens cassés, les titres manquants, les redirections, les pages orphelines et de nombreux problèmes techniques.
Pour commencer, une vérification régulière des points suivants suffit déjà à repérer une bonne partie des obstacles :
- Le fichier robots.txt est-il accessible et correctement configuré ?
- Le sitemap XML contient-il uniquement des URL pertinentes ?
- Les pages importantes sont-elles accessibles en quelques clics ?
- Le site comporte-t-il de nombreuses erreurs 404 ou 500 ?
- Les pages stratégiques sont-elles indexées dans Google ?
- Le serveur répond-il rapidement et de manière stable ?
Les bonnes pratiques pour rendre son site plus facilement crawlable
Améliorer le crawl ne demande pas forcément une refonte complète. Quelques actions bien ciblées peuvent déjà faire une différence sensible.
Commencez par construire une architecture simple et logique. Organisez les contenus par thématiques et limitez la profondeur des pages importantes. Un internaute comme un robot doit pouvoir atteindre les informations essentielles sans traverser un labyrinthe digne d’un vieux jeu vidéo.
Travaillez ensuite votre maillage interne. Ajoutez des liens contextuels entre les articles, les pages de services et les catégories. Vérifiez régulièrement qu’aucune page stratégique n’est isolée.
Nettoyez également les URL inutiles : anciennes pages, paramètres superflus, filtres sans valeur SEO et doublons. Utilisez les balises canoniques lorsque plusieurs URL peuvent afficher un contenu similaire, mais ne les considérez pas comme une solution magique à tous les problèmes de duplication.
Enfin, surveillez la performance technique. Un site lent augmente le risque d’abandon chez l’utilisateur et peut limiter le nombre de pages explorées par les robots. Compression des images, mise en cache, hébergement fiable et code optimisé forment une équipe beaucoup plus efficace que trois plugins installés au hasard.
Crawler web et stratégie SEO : le bon réflexe
Le crawler n’est pas un simple visiteur automatique. Il constitue le premier intermédiaire entre votre site et les moteurs de recherche. Si ses déplacements sont fluides, vos contenus ont davantage de chances d’être découverts, compris et indexés.
Le SEO technique ne remplace pas un contenu utile ni une stratégie de netlinking solide. Il crée les conditions nécessaires pour que ces efforts portent leurs fruits. Un excellent article mal accessible reste invisible. Un site parfaitement crawlable mais dépourvu de valeur ne deviendra pas une référence pour autant.
La meilleure approche consiste donc à réunir trois ingrédients : une architecture claire, des contenus pertinents et une popularité construite grâce à des liens de qualité. Les robots pourront alors explorer votre site efficacement, tandis que les internautes auront une vraie raison d’y rester.